AI 에이전트를 만들며 다시 보게된 데이터
최근 ‘One Team, One Agent’를 목표로, 각 팀이 기존 업무 중 AI로 전환·자동화할 수 있는 업무를 직접 발굴하고 이를 AI 에이전트로 구현해보는 AX 캠페인을 진행했다. 특허·논문 관리, SQL 자동생성, 코드 리뷰, 연구과제 운영 등 각 팀이 선택한 업무는 달랐지만, 실제 구현 과정에서는 한 가지 공통점이 나타났다.
AI가 업무를 수행하려면 결국 그 업무에 필요한 데이터를 찾아 읽고, 정리하고, 연결해야 한다는 점이다.
각 팀은 여러 곳에 흩어진 데이터를 가져와 필요한 정보를 추출하고 정리하거나, DB와 API를 연동하고, 업무규칙과 도메인 지식을 AI가 활용할 수 있는 형태로 구성하는 등 저마다의 방식으로 기업의 데이터를 AI에 연결했을 것이다.
우리는 흔히 이를 ‘AI 서비스를 만들었다’고 표현한다. 그러나 실제 작업의 상당 부분은 새로운 AI 모델을 만드는 일이 아니라 회사에 이미 존재하던 데이터를 AI가 사용할 수 있는 형태로 준비하는 일이었을 것이다.
이 글은 여기에서 생긴 질문에서 출발한다.
우리는 지금까지 축적해 온 데이터를 얼마나 잘 활용하고 있을까?
기업은 데이터가 아니라 ‘기억’을 쌓아왔다
기업은 오래전부터 수많은 데이터를 축적해 왔지만, 이를 ‘활용 가능한 자산’으로 바라보는 시각과 범위는 과거와 크게 달라졌다.
과거 기업의 데이터 활용은 주로 업무시스템과 데이터베이스에 구조화되어 저장된 정형 데이터를 중심으로 이루어졌다. 이제는 문서와 이메일, 음성, 영상, 센서와 이벤트 스트림까지 AI가 직접 분석하고 활용할 수 있는 범위로 들어오고 있다.
AI의 발전은 새로운 형태의 기업 데이터를 만들어냈다기보다, 그동안 활용하기 어려웠던 기록까지 분석과 지식화의 대상으로 끌어들이고 있는것이다.
그 규모 또한 이미 사람이 직접 읽고 이해할 수 있는 범위를 훨씬 넘어섰다. 글로벌 시장조사 기관인 IDC(International Data Corporation)에 따르면 2025년 기업이 생성한 데이터는 초당 6.9PB(Petabyte)에 달했으며, Agentic AI 확산과 함께 2029년에는 초당 17.1PB로 약 2.5배 증가할것으로 내다봤다. 또한 전세계에서 10억 개가 넘는 AI Agent가 데이터를 생성하고 소비하는 환경까지 더해질 것으로 예상하고 있다.
2006년 영국의 수학자이자 데이터 분석가 Clive Humby는 “Data is the new oil”이라는 유명한 표현을 남겼다. 이 비유의 핵심은 데이터의 양 자체가 가치를 보장한다는 뜻이 아니라, 원유가 정제되어야 가치를 갖듯 데이터 역시 가공되고 활용되어야 비로소 가치를 창출한다는데 있었다.
20년이 지난 지금도 이 본질은 크게 달라지지 않았다. 달라진 것은 데이터를 가공하고 활용할 수 있는 기술의 범위이다. 과거에는 사람이 분석해야 했던 데이터를 이제 AI가 읽고, 검색하고, 서로 연결하며, 그 안의 의미와 관계까지 파악하고 활용하기 시작하고 있다.
예를 들어, 과거의 한 제안 프로젝트에는 RFP, 제안서, 회의록, 견적자료, 기술검토 의견과 수주 결과가 각각 다른 형태로 남아 있다. 하나씩 보면 특정 업무를 수행하며 만들어진 기록들이지만, 이를 연결하면 고객이 무엇을 요구했고 우리는 어떤 기술과 전략을 제안했으며, 어떤 판단을 내렸고 결과가 어떠했는지에 대한 하나의 경험이 된다.
이러한 경험이 여러 프로젝트에 걸쳐 연결되면, 반복되는 고객 요구사항이나 효과적이었던 제안 방식, 성공과 실패에서 얻은 패턴까지 다시 활용할 수 있다.
기업의 데이터는 본래 각각의 업무 목적에 따라 만들어졌다. 회의록은 회의를 기록하기 위해, 이메일은 의사소통을 위해, 제안서는 사업을 위해, 이슈는 업무를 관리하기 위해 만들어졌다. 이렇듯 기업은 AI를 위해 데이터를 쌓아온 것은 아니지만, 결과적으로 AI가 활용할 수 있는 ‘기업의 기억’을 오랜 시간 축적해 온 셈이다.
데이터가 더 높은 가치로 발전하는 과정을 설명하는 DIKW(Data–Information–Knowledge–Wisdom)의 관점에서는 데이터(Data)에 의미와 맥락이 더해지면 정보(Information)가 되고, 정보 사이의 관계와 패턴을 이해하면 지식(Knowledge)이 되며, 그 지식을 실제 판단과 행동에 활용하면 지혜(Wisdom)로 발전한다고 본다.
오늘날의 복잡한 데이터 환경을 이 오래된 개념 하나로 모두 설명할 수는 없지만 한 가지 질문은 여전히 유효하다.
그렇다면 기업에 축적된 수많은 데이터 가운데, 실제 업무에 다시 활용할 수 있는 지식으로 연결된 것은 얼마나 될까?
데이터가 여러 시스템과 문서에 흩어져 있거나, 서로 무엇을 의미하며 어떤 관계를 갖는지 충분히 연결되어 있지 않다면 이를 다시 활용 가능한 지식으로 발전시키기는 쉽지 않다. 기업이 축적해 온 데이터가 ‘기업의 기억’이라면, 흩어진 기억에 의미와 맥락을 부여하고 서로 연결하는 과정은 과거의 경험을 다시 활용할 수 있는 ‘기업의 지식’으로 발전시키는 일이라고 볼 수 있다.
이러한 전환을 뒷받침하는 데이터 기술 역시 AI의 발전과 함께 빠르게 변화하고 있다.
데이터 기술은 어디까지 왔을까
최근 데이터 기술의 변화에서 눈에 띄는 점은 새로운 기술 하나가 과거의 기술을 대체하고 있다기보다, 데이터를 활용하는 주체와 방식이 달라지고 있다는 점이다.
과거 데이터 플랫폼의 주요 소비자는 사람이었다. 데이터를 수집·정제해 저장하고 분석가가 SQL이나 BI 등을 통해 필요한 정보를 조회·분석하고 그 의미를 해석하는 방식이 중심이었다.
생성형 AI의 등장 이후에는 RAG와 Vector Search를 통해 문서와 같은 비정형 데이터까지 AI가 직접 검색하고 활용할 수 있는 범위가 크게 확대됐다.
이제 데이터의 주요 소비자가 사람에서 AI로 확대되면서, 단순히 AI가 데이터를 ‘찾을 수 있게’ 만드는 것을 넘어 그 의미와 맥락을 정확하게 이해하고 활용할 수 있도록 데이터를 준비하는 것이 새로운 과제로 떠오르고 있다.
이처럼 데이터가 특정 AI 활용 목적에 맞게 품질, 의미, 맥락, 출처와 거버넌스 등을 갖춰 신뢰성 있게 사용될 수 있도록 준비된 상태를 흔히 AI-ready Data라고 부른다. Gartner 역시 AI-ready Data는 단순히 데이터 품질이 높은 상태가 아니라, 실제 AI Use Case에 맞게 데이터의 적합성·Metadata·Semantics·Lineage·Governance 등이 함께 갖춰져야 한다고 설명한다.
특히 AI Agent가 기업의 데이터를 직접 탐색하고 판단과 업무 수행에 활용하기 시작하면서 데이터의 의미(Semantics)가 더욱 중요해지고 있다.
Gartner는 2027년까지 AI-ready Data에서 Semantics를 우선시하는 조직은 Agentic AI 정확도를 최대 80% 높이고 비용을 최대 60% 줄일 수 있을 것으로 전망했다. 데이터의 값이나 형식만 제공하는 것이 아니라, 그 데이터가 기업에서 무엇을 의미하고 어떤 규칙과 관계를 갖는지까지 제공해야 한다는 의미다.
흥미로운 점은 이를 구현하는 기술 자체가 완전히 새로운 것은 아니라는 것이다. 데이터에 의미와 맥락을 부여하고 관계를 연결하는 데 활용되는 Metadata, Semantic Layer, Ontology, Knowledge Graph 등의 기술은 오래전부터 존재해 왔다. 달라진 것은 이 기술들의 역할과 결합 방식이다.
Microsoft는 2025년 Ignite에서 Fabric IQ를 공개했다. Fabric IQ는 기업의 데이터와 운영시스템을 비즈니스 Entity와 관계 중심으로 연결하고, Ontology를 팀·AI Agent·Workflow가 함께 사용할 수 있는 공유 Business Model과 Context Layer로 활용하는 구조를 제시하고 있다. 현재 Fabric IQ Ontology는 Preview 상태이며, 실제 데이터와 Ontology를 연결하고 Agent가 이를 Context Source로 사용할 수 있도록 지원한다.
Microsoft는 더 나아가 Microsoft IQ를 통해 Work IQ, Fabric IQ, Foundry IQ, Web IQ를 연결하는 엔터프라이즈 인텔리전스 계층을 제시하고 있다.
이를 종합하면 최근 데이터 기술의 방향은 비교적 분명하다.
정형 데이터뿐 아니라 문서와 같은 비정형 데이터를 AI가 직접 검색·활용하고, Metadata를 통해 데이터의 출처와 속성을 파악하며, Ontology를 통해 업무 개념의 의미와 관계를 이해하고, Knowledge Graph를 통해 실제 데이터 사이의 연결관계를 탐색·활용할 수 있는 단계로 발전하고 있다.
여기에 실시간 데이터까지 연결되면서 AI가 변화하는 업무 상태를 바탕으로 판단하고 행동할 수 있는 기반도 만들어지고 있다.
최신 데이터 기술의 핵심은 새로운 데이터베이스나 그래프 기술 하나에 있지 않다.
이미 축적된 정형·비정형·실시간 데이터를 AI가 신뢰성 있게 활용할 수 있도록 품질과 의미, 관계, 맥락을 갖추는 ‘AI-ready Data’ 중심의 데이터 기반으로 변화하고 있다는 점이 더 중요하다.
AI Agent가 늘어나면 새로운 Data Silo가 생길 수 있다
이러한 기술의 변화는 우리가 진행했던 AX 캠페인을 다시 돌아보게 한다. 캠페인에서 각 팀은 자신의 업무를 AI로 전환하기 위해 필요한 데이터를 찾고, 정리하고, 각자의 Agent가 활용할 수 있는 형태로 만들었다. 개별 Agent를 빠르게 구현하는 단계에서는 자연스럽고 필요한 과정이다.
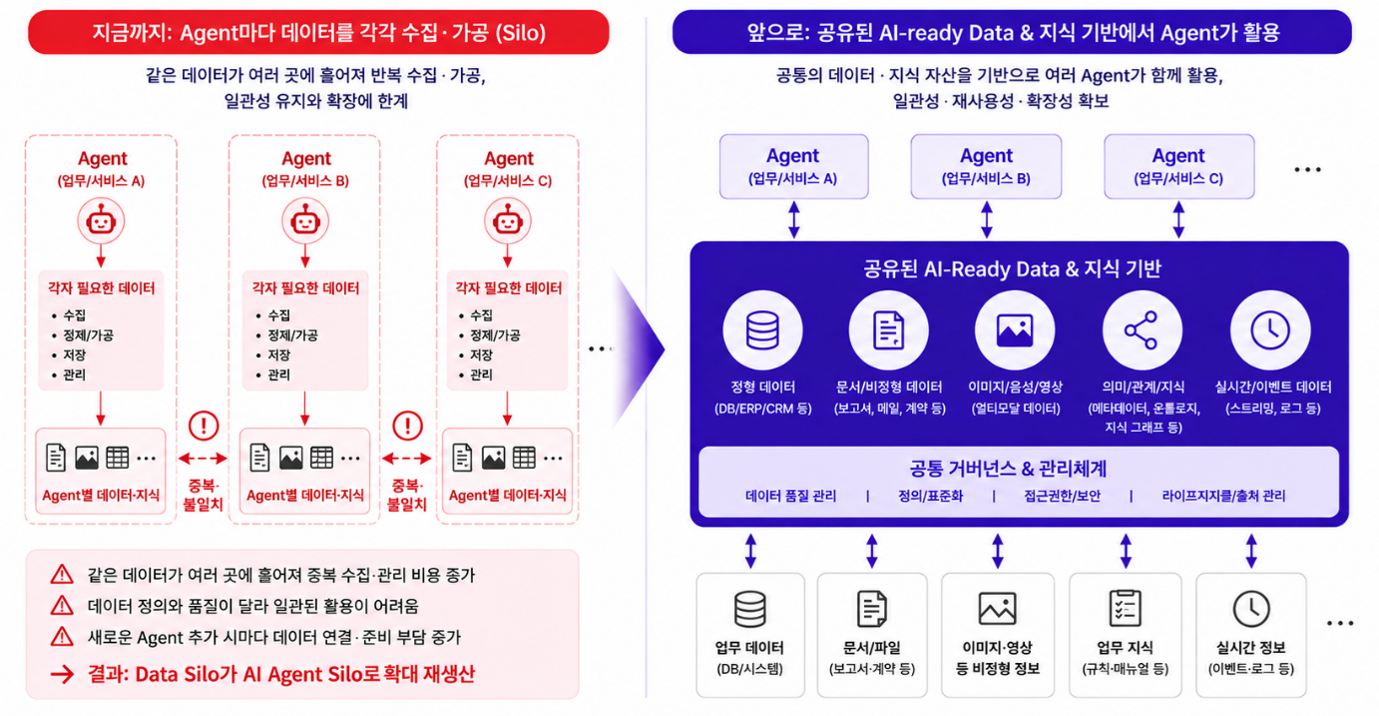
하지만 이러한 방식으로 Agent가 조직 전체에 하나둘 늘어나기 시작하면 새로운 문제가 생길 수 있다. 같은 고객·제품·과제 데이터를 여러 Agent가 각자의 목적에 맞게 다시 수집하고 가공하거나, ‘고객’, ‘과제’, ‘성과’처럼 같은 업무 개념을 서로 다른 기준으로 이해할 수 있기 때문이다.
결국 기존에는 데이터가 시스템과 조직별로 분리되는 Data Silo가 문제였다면, 앞으로는 동일한 기업 데이터를 Agent마다 다시 수집하고 해석하면서 Agent 단위의 새로운 Silo가 만들어질 가능성도 있다.
Agent가 몇 개 되지 않을 때는 큰 문제가 아닐 수 있다. 하지만 Agent가 늘어날수록 같은 데이터를 반복해서 준비해야 하고, 어느 데이터가 최신인지, 같은 개념을 Agent마다 동일하게 이해하고 있는지 관리하는 일도 점점 복잡해진다.
따라서 AX의 다음 단계에서는 “각 Agent에 어떤 데이터를 넣을 것인가?”를 넘어, “기업의 데이터와 지식을 어떻게 준비해야 여러 Agent가 함께 신뢰하고 재사용할 수 있는가?”라는 질문도 함께 고민할 필요가 있다.
그렇다면 무엇부터 준비해야 할까
그렇다고 모든 기업 데이터를 하나의 거대한 Knowledge Graph로 만들거나 새로운 데이터 플랫폼부터 구축해야 한다는 의미는 아니다.
정형 데이터의 조회와 분석에는 SQL이 적합할 수 있고, 문서 검색에는 RAG가 유용할 수 있다. 여러 시스템에서 공통된 업무 의미와 지표를 일관되게 제공해야 한다면 Semantic Layer가, 개체 사이의 복잡한 관계를 탐색하고 연결해야 한다면 Knowledge Graph가 적합할 수 있다.
중요한 것은 기술부터 고르는 것이 아니라 기업 데이터를 다시 활용할 수 있는 상태로 준비하는 것이다.
가장 먼저 살펴볼 것은 여러 Agent가 반복해서 필요로 하는 데이터가 무엇인지다. 두 개 이상의 팀이 동일한 고객정보나 제품정보, 과제정보를 각자 수집하고 가공하고 있다면 그것은 개별 Agent의 데이터가 아니라 기업 차원에서 공동 관리할 데이터 자산의 후보일 수 있다.
다음으로는 핵심 업무 개념의 의미를 맞출 필요가 있다. 고객, 제품, 과제, 성과, 완료와 같은 용어를 여러 시스템과 팀이 서로 다른 의미로 사용한다면 아무리 좋은 AI를 붙여도 Agent별 판단은 달라질 수 있다. 처음부터 복잡한 Ontology를 구축하기보다 반복적으로 사용되는 핵심 개념과 관계부터 명확하게 정의하는 것이 출발점이 될 수 있다.
마지막으로 어떤 데이터가 기준이고 누가 최신성을 관리할 것인지 정해야 한다. 같은 고객이나 제품에 관한 데이터가 여러 시스템에 존재한다면 어느 데이터가 기준인지, 누가 관리하고 변경사항이 어떻게 반영되는지를 알아야 여러 Agent가 같은 근거를 사용할 수 있다.
이러한 기반이 준비되어야 각 Agent가 매번 데이터를 처음부터 다시 만들기보다, 기업이 공동으로 관리하는 데이터와 지식을 필요에 따라 재사용하는 구조로 발전할 수 있다.
다음 그림은 이러한 데이터와 지식의 재사용 구조로 발전하기 위한 목표 모습을 AI Knowledge Base(AKB)로 표현한 것이다.

다시, 처음의 질문으로
이 글은 다음 질문에서 시작했다.
“우리는 지금까지 축적해 온 데이터를 얼마나 잘 활용하고 있을까?”
지금까지 살펴본 기술의 변화와 AX 캠페인의 경험을 돌아보면, 이제 이 질문은 단순히 데이터를 얼마나 많이 보유하고 있는지를 묻는 것이 아니다. 우리가 축적한 데이터가 얼마나 잘 이해되고 연결되어, 필요할 때 사람과 AI가 다시 활용할 수 있는 ‘기업의 지식’으로 준비되어 있는지를 묻는 질문에 가깝다.
어쩌면 앞으로 기업의 AI 경쟁력을 가르는 차이는 가장 좋은 AI 모델을 가진 기업이 아니라, 자신이 오랜 시간 축적해 온 데이터를 가장 잘 이해하고 연결해 ‘기업의 지식’으로 만들어 놓은 기업에서 시작될지도 모른다.
참고문헌
1. IDC, The Enterprise AI Intelligence Gap: What the Data Shows, 2026. 2025년 기업 데이터 생성량 6.9PB/sec, 2029년 17.1PB/sec 전망.
2. IDC, Agent Adoption: The IT Industry’s Next Great Inflection Point, 2025. 2029년 전 세계 운영 AI Agent 10억 개 이상 전망.
3. IDC, AI Can’t Run on Stale Data: Rethinking Enterprise Architecture, 2026. 기업의 AI Agent 운영·도입 현황 및 실시간 데이터 아키텍처 변화.
4. IDC, Converged Workloads: A Framework for Building the Real-Time Enterprise, 2025. 2029년 기업 데이터 플랫폼의 Transactional·Analytical Workload 통합 전망.
5. Gartner, What Is AI-Ready Data? And How to Get Yours There. AI-ready Data의 Use Case 적합성, Metadata, Semantics, Quality, Trust, Lineage 및 Governance 요건.
6. Gartner, How Data Scientists Can Determine Whether Data is AI-Ready, 2025. AI-ready Data는 고정된 상태가 아니라 Use Case에 따라 판단해야 하는 개념임을 설명.
7. Gartner, Gartner Says Lack of Semantics Causes Inaccurate AI Agents and Wasted Spending, 2026. 5. 11. AI-ready Data에서 Semantics 우선 시 Agentic AI 정확도 최대 80% 향상 및 비용 최대 60% 절감 전망.
8. Gartner, Top Trends in Data and Analytics for 2026, 2026. AI Agents, Semantics, Data & Analytics Platform Convergence를 주요 트렌드로 제시.
9. Gartner, Top Trends in D&A for 2026: Making Composite Semantic Layers Interoperable, 2026. Composite Semantic Layer를 통한 다양한 의미체계의 연결과 데이터 사일로 완화 방향.
10. Gartner, Top Trends in D&A for 2026: Real-Time Acceleration With Agentic Data Streaming, 2026. Agentic AI를 위한 실시간 데이터 스트리밍의 중요성.
11. Microsoft Learn, Microsoft IQ Documentation, 2026. Work IQ, Fabric IQ, Foundry IQ, Web IQ를 결합한 엔터프라이즈 AI용 통합 Intelligence Layer 설명.
12. Microsoft Learn, What Is Ontology (Preview)? – Microsoft Fabric, 2026. Fabric IQ Ontology를 팀·Agent·Workflow가 공유하는 Business Model 및 Context Layer로 설명.
13. Microsoft Learn, Agent Integration Options for Ontology (Preview), 2026. AI Agent가 Ontology를 공유된 비즈니스 의미·관계·규칙의 Context Source로 활용하는 구조.
14. Microsoft, From Idea to Deployment: The Complete Lifecycle of AI on Display at Ignite 2025, 2025. Fabric IQ와 Foundry IQ를 통한 데이터와 비즈니스 의미의 연결 및 Agent 활용 방향.
15. Rowley, J. E., “The Wisdom Hierarchy: Representations of the DIKW Hierarchy,” Journal of Information Science, Vol. 33, No. 2, 2007.

'R&D' 카테고리의 다른 글
| AI를 제품에 적용할 때, 어디까지 맡겨야 하는가 by. 엘에스웨어 김원영 (0) | 2026.09.16 |
|---|---|
| AI 저작권 전쟁 2막- 학습 데이터에서 결과물 리스크로 by. 엘에스웨어 백승찬 (0) | 2026.07.13 |
| AI 모델 경량화의 핵심, 지식 증류 기술의 양면성과 보안 전략 by. 엘에스웨어 김현수 (0) | 2026.05.21 |
| 탐지를 넘어 신뢰로: 설명 가능한 AI(XAI)가 바꾸는 사이버 보안의 미래 by 엘에스웨어 김현수 (0) | 2025.10.02 |